多轮对话变长时,如何控制上下文长度并选择压缩策略?
未标记
询问 AI
考查重点:上下文预算与信息分层。按 token 预算保留当前目标、约束和最近工具结果;旧对话摘要或外置检索,接近预算时触发压缩
本题目录
参考答案
核心回答
控制上下文要区分完整历史的存储和本轮模型的输入。历史保存在 Redis 或检查点里,不代表模型会自动读到;本轮不发送旧消息,也不必删除原始记录。调用前应统计指令、工具定义、历史和工具结果的 token 占用,按模型窗口预留输出空间,在超限前处理长输入。
再按信息的后续用途选择策略:
- 保留原文:近期讨论、最新更正,以及需要精确引用的内容。
- 直接裁剪:已经结束、与当前任务无关的过程。
- 抽取或摘要:把当前目标、仍生效的约束、已确认进度和待核验事项整理成简短状态。
- 外置并按需取回:长网页、报告和旧材料放在外部存储,需要时再读取相关原文。
例如报告范围从“上半年”改成“第二季度”,摘要要保留新范围和原有的来源要求。取舍是否合理,要用多轮任务检查约束、更正和关键事实有没有丢;质量达标后,再比较 token、耗时与成本。
下面用一个 32,000 token 的预算例子,把“保留、裁剪、摘要、外置”四种处理方式放在一起比较。报告范围发生更正时,也要把新约束带入下一轮。
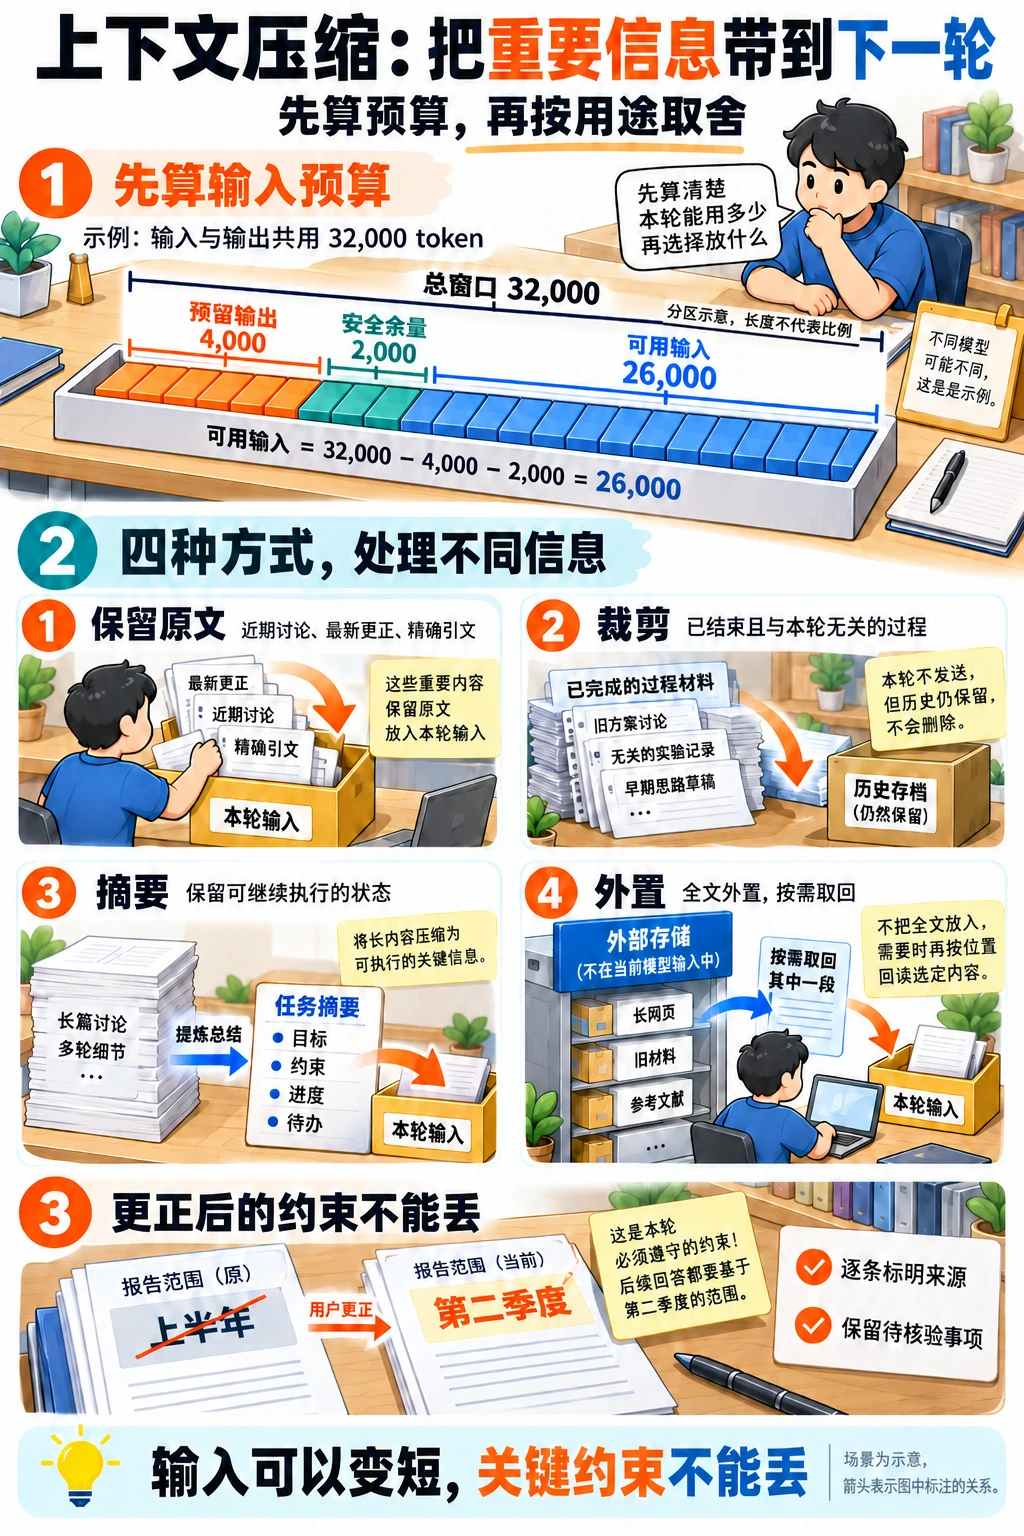
先找到占用来源,再决定在哪里处理
轮数不能代替容量:十轮短问答可能很小,一次工具调用返回整份网页就可能很大。应在模型调用前,检查实际要发送的完整输入,而不只是用户聊天记录;工具返回后继续执行时,还要重新检查。
如果大头是工具结果,优先在源头缩小返回范围:数据库只查需要的列和行,搜索先给候选和摘要,阅读工具按章节或片段取原文。需要保留全文时,可以保存全文并返回可回查的位置。这样比“每次取回全部内容,再调用模型总结”少一次不必要的长输入,也降低摘要丢信息的风险。
如果大头是旧对话,就区分仍生效的要求、已经完成的过程和后续可能回查的材料。压缩要提前触发,因为摘要模型本身也要读得下待压缩内容;触发点还受最大输出、近期长消息和预期工具返回大小影响,没有通用的“用到窗口 75% 就一定安全”。只按消息条数保留也不保险,一条消息可能比前二十条还长。
把窗口预算换算成可用输入
假设某模型允许输入与输出合计最多 32,000 token,为输出预留 4,000,再留 2,000 作为计数误差和输入波动的余量,本轮输入预算就是 26,000。若系统指令和工具定义已经占了 3,000,那么历史、当前用户消息、检索材料和工具结果合计最多再放 23,000 token。这些数字只是预算算例,实际还要核对目标模型独立的输入、输出及其他占用限制,余量也应结合任务调整。
如果一次工具返回就有 25,000 token,即使清空旧历史,也放不进上面剩余的 23,000。此时要缩小工具返回范围,或者把原材料外置后按章节读取、分块处理;每次用于摘要的请求也要满足摘要模型自己的输入预算。处理后重新计数,再继续原任务。只反复压缩旧对话,无法解决新材料本身就过长的问题。
用同一个报告任务选择策略
设想用户先要求“分析上半年,逐条标明来源”,中途更正为“只分析第二季度”,之后又阅读了很多网页。下一轮写报告时,当前有效范围是第二季度,旧的“上半年”已经被替代。
可以按后续用途处理这些内容:
- 保留近期原文:最新更正、正在修改的段落和未完成的工具交互要准确延续。它保真度高,但保留太多仍会占满窗口。
- 直接裁剪:已经结束、与本轮无关的话题可以不发送。做法简单、没有摘要调用成本,但机械地只留最近几轮,容易把开头的来源要求一起删掉,所以仍生效的限制要另行保留。
- 抽取或摘要:把当前目标、已确认结论、下一步和待核验事项写成简短状态。数字、引文、条款等需要精确使用的内容,优先保留必要原句和出处。摘要适合延续任务,但会有遗漏和改写风险,不能把它当成无损备份。
- 外置并按需取回:完整网页、旧报告和较早的搜索材料保留在外部,当前输入只放材料标识与必要说明。后续比较某条原文时再取回相关段落。这样节省常驻上下文,但增加检索延迟,也可能没找对材料;仅存一个网址不等于已经保存了可复用的原文版本。
本例的摘要可以写成:
当前任务:只分析第二季度;每条结论标明来源。
范围变更:最初的“上半年”已被用户更正,不再采用。
已确认事实:列出核验后的要点和对应原文位置。
待核验事项:某条数据仍缺来源,不能作为定论写入报告。
下一步:补齐该来源,再修改报告的比较段落。
工作材料:当前报告版本、资料标识及可读取的原文位置。
如果摘要只剩“用户想研究近期情况,已经查过很多资料”,它虽然很短,却丢了时间范围、证据要求和下一步。反复用旧摘要生成新摘要,还可能把“准备核验”逐步写成“已经核实”。更新摘要时,把补充信息并入对应事项,去掉重复内容,按用户最新要求替换已失效的条件;资料冲突尚未核清时保留出处和待核验状态,精确引用仍重新读原文。
原消息、任务状态和长期记忆怎样分工?
原消息是可回查的记录,摘要是为下一步准备的工作状态,本轮上下文是本次实际发送给模型的内容。 三者可以同时存在,不能因为有摘要就默认原消息已经完整保留,也不能因为原消息仍在数据库里就默认它进入了本轮输入。
在 LangGraph 中,checkpointer 按线程保存执行状态,便于同一线程继续运行;Store 可以保存跨线程复用的信息。保存到数据库不会自动扩大模型窗口,后续仍要把所需内容读取并放入上下文。DeepAgents 的 StateBackend 跟随当前线程状态,适合同一线程内的临时文件和中间结果,不能仅凭“文件还在”就当作跨会话长期记忆。长期偏好是否适合沉淀,还要看后续是否确实需要跨任务使用,不能把每次临时要求都升级成永久规则。
使用摘要中间件时,通常需要配置由哪个模型摘要(model)、什么时候触发(trigger)、保留多少近期原文(keep)。这些参数解决触发和保留范围,摘要内容该保留什么仍要围绕任务设计。
裁剪还要保持消息协议合法:工具调用和相应结果应按模型接口要求成组保留或移除,避免留下孤立的工具结果;未完成调用要保留恢复执行所需状态。系统指令、身份和权限由应用的可信配置管理,不能让自由生成的摘要成为授权依据。
追问:怎么判断取舍是否合理?
换成更大窗口,还需要压缩吗? 可以降低压缩频率。一次只分析少量长文,直接保留全文也可能更合适;多轮研究持续带上所有旧网页,则要比较实际输入成本、延迟和噪声影响。能装下,只能说明没有超过容量,不能证明所有内容对当前任务都有用。
如何确认没有压坏? 固定一批多轮任务,让原方案和压缩方案完成相同目标。除了最终答案,还检查几个容易丢失的点:开头的限制、中途更正、隔很多轮才再次用到的数字,以及已经完成和待完成事项的区别。本例就看报告是否只覆盖第二季度、来源是否正确、待核验内容是否仍保持未确定状态。对于需要重取资料的方案,还要检查是否能读回正确版本;质量达标后,再比较输入 token、额外摘要/检索调用、总耗时和成本。
对应教程
配套教程介绍消息历史、摘要触发和存储分工;本文结合报告范围更正,展开摘要应保留哪些信息,以及怎样检查压缩后的任务结果。
- 第 16 章:记忆与对话历史:§3 的读历史、注入当前输入及长历史处理。
- 深度研搜第 7 章:中间件机制与 Skills 配置:§3 的摘要参数和提前触发。
- 深度研搜第 6 章:长期记忆与 Backend 存储:§2 的执行状态、文件后端及线程范围。
参考资料
国外:Anthropic:Effective context engineering for AI agents:借鉴压缩历史、维护结构化笔记和按需取回资料的做法,组织长对话中的信息保留策略。
国外:LangChain:Short-term memory:参考消息裁剪和摘要的实现说明,补充压缩历史时如何保持工具调用与工具结果的对应关系。
国内:JavaGuide:RAG 基础概念:结合长上下文与检索方案的讨论,说明何时直接保留原文、何时把长材料外置后按需读取。
国内:火山引擎:上下文用量与压缩管理:参考早期历史摘要与近期原文并存的处理方式,并区分多轮累积超限与单次输入过长。
国内:JavaGuide:上下文工程:参考上下文预算与内容优先级的划分,说明本轮输入如何分配空间,以及它与跨轮摘要的关系。
国内:JavaGuide:Agent 记忆:参考大体积工具结果外置的做法,补充如何按需读取,以及如何限制单次读入上下文的大小。
国内:zero2Agent:记忆与上下文:借鉴摘要、外置存储与原文回查相结合的思路,说明上下文压缩可以按信息用途组合多种策略。
相关面经
88 篇
腾讯
后端开发工程师上下文压缩机制具体是怎么做的?
阿里巴巴
AI 应用研发工程师Agent上下文超限怎么处理?滑动窗口和摘要压缩各自牺牲了什么
字节跳动
AI Agent 开发工程师那 Agent 上下文超长怎么压?
百度
后端开发工程师(AI)上下文超了如何解决?
腾讯
后端开发工程师(Agent 项目)内容很长的话会超出上下文窗口吗
展开剩余 83 篇面经

蚂蚁集团
你了解 OpenManus 的 Memory 管理是怎么处理上下文超限问题的吗?
百度
上海联蔚数科
AI 工程实习生(Agent 方向)你的coding agent没有用框架,那你是怎么实现上下文压缩,记忆处理的。
阿里巴巴
AI 应用开发工程师用户不断追问时,Agent 的上下文会不会无限增长?你是怎么管理上下文长度的?
MemTensor
全栈开发工程师对话窗口有限时,上下文压缩/摘要机制怎么设计?
格物致信
Agent 上下文窗口膨胀你是怎么解决的?难点是什么?

维他奶
Java 开发工程师上下文爆炸怎么办
上海九云数智
大模型应用开发工程师(RAG 方向)你可以说说你这个项目的上下文治理是怎么做的吗
百度
Agent 应用开发工程师如果设计了多轮工具调用,上下文是怎么管理的?
虾皮
Agent 应用开发工程师项目里面上下文压缩是怎么做的?
科大讯飞
Java 开发工程师记忆系统,上下文过长怎么处理的
字节跳动
前端开发工程师智能体管理本身的能力呢?有做上下文管理吗
字节跳动
Agent 开发工程师随着提问轮次的增加,上下文窗口会越来越大,该如何进行解决?
字节跳动
Agent 全栈开发工程师记忆压缩怎么做?进行到第十一轮时,应该给模型哪些信息?
小红书
AI Native 全栈开发工程师简历里面的最近 N 轮 + Summary 的上下文管理机制是怎么做的?/上下文膨胀问题你是怎么解决的
去哪儿
前端开发工程师上下文无限膨胀有哪些处理方案?
字节跳动
后端开发工程师(AI 平台)百度
后端开发工程师(Agent)百度
Agent 应用开发工程师追问:摘要压缩是怎么做的
中兴
软件开发工程师如何处理大模型上下文窗口膨胀的问题?

小鹏
后端开发工程师(AI / Agent 方向)展开讲一下你怎么解决上下文过长、幻觉这个问题?你是怎么解决的?
蔚来
Java 开发工程师Agent 长轮次执行上下文越积越多,上下文膨胀问题的压缩治理方案。
虾皮
Agent 应用开发工程师如果有一个超长上下文任务比如前端相关的,1M也远远不够,这个时候你怎么做(讲工程实践)
百度
Go 后端开发工程师(Agent)你们做上下文压缩了吗?具体是怎么做的?
小鹏
Agent 开发工程师Agent上下文过长时采用了什么压缩策略?实际节省了多少Token?
多益网络
AI 应用开发工程师你的压缩策略是怎么设计的
美团
Agent 开发工程师Agent运行过程中上下文信息如何管理?如何避免上下文过长导致模型效果下降?
百度
大模型研发工程师(Agent 方向)Agent 上下文越来越长,快超过 Context Window 时一般怎么处理?如果让你设计上下文压缩,会怎么设计?
虾皮
Agent 开发工程师当对话内容超过模型上下文窗口限制时,通常有哪些处理方案?滑动窗口和动态摘要分别有什么优缺点?
京东
后端开发工程师讲讲上下文压缩
百度
后端开发工程师多轮对话压缩在你的系统里怎么做的?
哔哩哔哩(B站)
Agent 应用开发工程师Compacting策略?
阿里巴巴
Agent 应用开发工程师上下文管理,工程过大上下文爆炸,怎么解决或者改善
顺丰
Agent 开发工程师上下文压缩怎么实现
阿里巴巴(淘天)
Agent 开发长对话里 Skill 被注意力稀释怎么解决?
CVTE
AI 应用开发上下文压缩怎么实现
深信服
Agent 开发Agent长上下文问题你怎么处理?(上下文压缩)
快手
Agent 开发上下文窗口不够了怎么办?截断、摘要压缩、检索召回怎么取舍?
小红书
Agent 开发Agent上下文管理通常如何设计?如果上下文过长,会采用哪些方式进行拆分或压缩?
影石创新
AI Agent 开发在 Agent 开发过程中,上下文为什么需要进行压缩?压缩后可能导致信息缺失,应该如何解决?
哔哩哔哩(B站)
Agent 开发工程师超长上下文压缩
超参数
Agent 开发工程师上下文压缩怎么做

转转
FDE超长对话怎么解决
字节跳动
Agent 开发长上下文有哪些处理方案?
法本信息
AI Agent 开发你提到做了多轮任务中的上下文治理,可以举一个真实场景吗?比如代码改到一半上下文越来越长,你是怎么处理的?
滴滴
AI Agent 后端开发如果要做记忆压缩,通常有哪些方法?
FOSHO
AI 应用开发长时间编程任务很容易超出模型上下文窗口,你采用了什么上下文压缩机制?
百度
Java 开发工程师(智能客服)你的上下文压缩是怎么做的?
百度
AI 应用开发工程师阿里巴巴
Agent 应用开发工程师多Agent项目是不是主子架构。某个功能单次会话的token大概有多少,有没有超过模型限制。用的Qwen具体是哪个版本。
佰聆数据
AI 应用开发工程师如果让你设计一个上下文管理功能,你会设计什么内容呢?

硅心科技
智能软件工程师多轮会话压缩的机制是什么样的
国金证券
Java 开发工程师腾讯
后端开发工程师你说你用superpowers这个skill,那你可以说一下你怎么去解决superpower输出对上下文造成大量占用这一问题吗?
快手
Agent 应用开发工程师检索内容过多,如何去裁剪?
百度
Agent 应用开发工程师Agent 怎么处理长文本
招银科技
后端开发工程师(AI / Agent 方向)以及长上下文处理。
不鸣科技
AI 应用开发工程师(AI Native)上下文压缩怎么做的,如果在任务过程中压缩上下文导致之前的流程丢失,你会怎么解决这个问题
字节跳动
Agent 应用开发工程师压缩机制是做的?上下文窗口总token多大?触发上限为什么选这个值?
字节跳动
全栈开发工程师(Agent)agent的上下文窗口满了怎么办,如何去进行压缩,有哪几种方式?
深信服
在长程任务重,agent有可能做着做着压缩了上下文丢失了很多细节,你是如何处理的?
阿里巴巴
AI 应用开发工程师下文结构是怎么组织的?有没有进行长度约束?
字节跳动
后端开发工程师压缩上下文的方法
美团
后端开发美团
后端开发超出上下文窗口怎么办?
腾讯音乐
后端开发那会话记忆超出上下文窗口怎么办?

OPPO
后端开发工程师如何处理上下文超限
美团
Agent 开发工程师(智能客服)上下文超长了怎么办?有没有考虑过上下文压缩?
快手
Moka
后端开发工程师(AI)会考虑做一个消息的裁剪吗
阿里国际
AI 应用 / Agent 开发上下文压缩办法
作业帮
大模型算法工程师上下文管理方法,怎么优化的,不同优化方式有什么理解吗
快手
Agent 应用开发工程师美团
后端开发工程师上下文太长导致幻觉,怎么解决?
字节跳动
Agent 开发工程师长上下文场景下,你做过哪些上下文压缩、信息筛选的优化手段?
阿里巴巴
Agent 应用开发工程师3.4 Claude code如何解决 上下文爆炸问题
小红书
Agent 算法工程师你们上下文是怎么管理的?
未知公司
上下文窗口不够用,对话太长怎么办?
得物
大模型算法工程师上下文 & 记忆机制
字节跳动
AI 后端 / Agent 开发当对话轮数很多,上下文窗口不足时,有哪些处理策略?(如截断、压缩)
字节跳动
AI 开发工程师agent上下文维护方案
未知公司
Agent 实习岗字节跳动
后端开发工程师上下文超过一定长度后如何压缩?
收录题集

展开剩余 28 份题集
Agent与工具调用
长上下文
长上下文处理方法 长上下文处理方法:包括上下文窗口限制原因、信息遗忘(lost in the middle)、工程化突破(如KIMI、Qwen)、上下文压缩、序列长度扩展、模型架构改进等。
Prompt与上下文
Tokenizer与Embedding
AI系统与训练推理工程

Agent 与自主系统
大模型基础
LLMOps 与生产应用

AIGC时代AI Agent基础
Agent记忆与上下文工程
Agent 工程追问
阿里巴巴问答汇编
百度高频面试题
字节跳动高频面试题
美团高频面试题
月之暗面高频面试题
拼多多高频面试题
腾讯问答汇编
算法思想与AI应用
提示工程:应用大模型的高级方法

大语言模型

AI 智能体与大模型应用开发面试题库

大模型基础面试题
Agent开发面试题

模型架构与注意力
模型与 NLP 基础

记忆与上下文:长对话不丢信息的实战方案
OpenClaw 教程面试题
相关关键词:上下文压缩、Context Compression、Context Window