Attention 基础
3 道题目查看参考回答收起参考回答
Transformer 用注意力在序列位置之间交换信息,再用逐位置前馈网络变换特征,通过残差连接、归一化和多层堆叠形成上下文表示。 Token Embedding 提供内容表示,位置机制提供顺序信息;模型再按任务将最终表示映射为分类结果、向量或下一个 Token 的概率。
原始 Transformer 是 Encoder–Decoder:编码器理解输入,解码器对已有输出做因果自注意力,并通过交叉注意力读取编码器结果,逐步生成目标序列。现代生成式 LLM 常采用 Decoder-only,把提示词与已有输出放进同一序列,使用因果注意力预测下一个 Token,选出后继续生成。
因此,整体原理不能只停在 Q/K/V 公式:还要说明输入怎样变成表示、Block 怎样加工、输出怎样生成,以及训练时的并行计算为何不等于生成时一次得到全部 Token。
来源 · 1 篇面经合集 · 6 篇面经 · 19 份题集收起来源
八股:讲讲transformer架构
【Transformer原论文结构】原论文中编码器和解码器各有几个? 「百度」
【Transformer注意力机制】Transformer注意力机制综合题: 1. 介绍Transformer组件:attention(除dk layernorm、rmsnorm、ffn、swiglu、MoE、lora和初始化)、GQA。 2. 介绍MHA的几种变体及改进方法。 3. 介绍FlashAttention。 4. 介绍长序列attention。 5. 手撕:实现多头自注意力(Multi-Head Attention)核心代码;实现多头注意力模块(MHA)并优化为MGA;实现多头注意力机制,包括softmax及数值溢出处理;写出自注意力伪代码(用abc预测第四个token,给定特征维度、头个数)。 6. 讨论多头注意力能否提高计算效率,并推导。 7. 在Agent多轮对话任务中,Attention的局限性体现在哪些方面? 8. 如果QK变成同一个矩阵会有影响吗?如何解决? 「京东、字节Seed、字节跳动、百度、美团、腾讯、腾讯混元、阿里巴巴、阿里通义」
简述一下Transformer的基本结构和原理
What are the key components of the Transformer architecture?
问题2:说下 Transformer 模型
1. Transformer、CLIP原理,图文对齐层工作机制
现在大模型是什么架构
问题4:Transformer 的结构整体介绍一下
2.Transformer 的基本结构怎么理解?
61. 简要介绍Transformer的Encoder模块和Decoder模块,两者的核心差异是什么?
39.介绍Transformer的Encoder模块和Decoder模块
10.Transformer架构是何时提出的?其核心创新点是什么,对深度学习发展有何影响?
面试问题:请完整介绍 Transformer 的整体架构,简述 Encoder 和 Decoder 的核心区别(输入、注意力类型、输出用途)。
2.请介绍下视频生成技术中的核心基础模型,比如GAN、VAE、Transformer、Diffusion Model等?
Walk through a transformer block. Why divide attention scores by √dₖ?
什么是Transformer的编码器和解码器?分别有什么用
讲讲 Transformer 架构基本原理?Encoder 和 Decoder 是什么?
Transformer 的整体架构、核心模块与实现流程是什么?
查看参考回答收起参考回答
Transformer 常用缩放点积注意力:先计算当前位置与各位置的匹配分数,再转成权重,对相应位置的信息加权求和,得到当前位置的新表示。 单个注意力头的计算分五步:
- 生成 Q、K、V:输入分别乘以三组可学习的投影矩阵。Query(Q)表示当前位置的查询,Key(K)提供各位置用于匹配的特征,Value(V)提供各位置被汇总的内容。
- 计算并缩放分数:用每个 Q 和所有 K 做点积,再除以 √d_k;d_k 是这个头中 Q、K 向量的维度。
- 加入可见范围约束:按任务需要加入 mask。例如自回归生成时,遮住未来位置,使当前位置只能读取自身及此前的信息。
- 归一化得到权重:对每个 Q 的分数沿 Key 位置做
softmax,得到它对各可见位置的权重,权重之和为 1。 - 加权汇总 V:用这些权重对相应的 Value 加权求和,得到这个头的输出。
公式为 Attention(Q,K,V) = softmax(QKᵀ/√d_k + M)V。这里 M 是加性 mask,可见位置为 0,被遮挡位置为负无穷。Self-Attention 的 Q、K、V 来自同一段输入;多头注意力使用不同的投影并行完成上述计算,再拼接各头输出、投影回模型需要的维度。
来源 · 12 篇面经 · 23 份题集收起来源
Transformer中Attention的本质是什么?你能从数学角度简要解释一下吗?
【MHA定义】MHA是什么? 「百度」
【Attention理解与量化】attention本身怎么理解、为什么attention往往比权重更难量化。 「蚂蚁集团」
请详细解释一下 Transformer 模型中的自注意力机制是如何工作的?它为什么比 RNN 更适合处理长序列?
What is self-attention, and how does it work in Transformers?
面试问题:Self-Attention 的核心计算是什么?
7.介绍一下Attention机制的原理?
6. 讲一下 Transformer 和 Self-Attention,Q、K、V 分别有什么作用,具体如何计算?
问题7:关于 attention 机制,三个矩阵 Q,K,V的作用是什么?
self-attention 的公式是什么?QKV 各是什么意思?
24. 请写出 Attention 计算公式,并解释原理。
72. Transformer 模型中的自注意力机制是如何工作的?可以解释一下“缩放点积注意力”吗?
24.介绍一下Transformer中的Self-Attention机制
面试问题:详细描述标准自注意力的完整计算流程(从输入 X 到输出),并解释 Q、K、V 的含义以及“为什么需要区分三者”。
面试问题:在大语言模型中,注意力(Attention),前馈层(FFN),残差连接和归一化各自解决什么问题?
面试问题:矩阵乘法、批量矩阵乘法和张量维度在 Transformer 中如何理解?
注意力机制是如何计算上下文各个词元之间的相关性的?每个注意力头只关注一个词元吗?
Attention 机制
请详细解释一下 Transformer 模型中的自注意力机制是如何工作的?它为什么比 RNN 更适合处理长序列?
Transformer 中 Attention 的核心原理是什么?
自注意力的计算方式和复杂度?
1.2 Attention的计算步骤是什么?
Transformer 自注意力机制的原理、计算过程与作用是什么?
查看参考回答收起参考回答
Scaled Dot-Product Attention在softmax前将QKᵀ除以√d_k,主要为了控制点积logits的尺度。维度增加时,未缩放点积的方差会增大,softmax更容易接近one-hot,使其Jacobian中的许多项很小,影响优化。这里d_k是每个注意力头中Q/K的维度,不是token长度,也不一定等于模型隐藏维度。
Attention(Q,K,V) = softmax(QKᵀ / √d_k)V
来源 · 2 篇面经 · 6 份题集收起来源
为什么在attention中要进行scaled(为什么除以√d_k)?
Why do we scale the dot product attention by √dₖ in the Transformer architecture?
Walk through a transformer block. Why divide attention scores by √dₖ?
自注意力中为何要缩放?
2.3 transformer的点积模型做缩放的原因是什么?
为什么在进行softmax之前需要对attention进行scaled(为什么除以dk的平方根),并使用公式推导进行讲解
位置编码与 RoPE
2 道题目查看参考回答收起参考回答
位置编码让模型在处理 Token 内容之外,利用它们在序列中的先后、位置和相对位移。比如“甲帮助乙”和“乙帮助甲”包含相同的词,但顺序改变了关系;这里的距离是分词后的位置差,不是词义的相似程度。
不带位置机制、采用全可见注意力的 Self-Attention,本身不会为序列顺序提供明确坐标。因此可以把绝对位置向量加入输入,也可以在注意力计算中引入相对位置偏置,或者像 RoPE 一样,按位置旋转 Q、K,让它们的点积包含相对位置信息。
这些方案的区别在于位置信息在哪里进入、是否需要学习,以及超出训练长度后怎样工作。编码公式能算到更远的位置,不代表模型就能可靠理解任意长文本;长上下文还要结合训练分布、缩放方案和实际任务验证。
来源 · 3 篇面经 · 11 份题集收起来源
【位置编码必要性】Transformer为什么需要位置编码?输入的序列本来就有先后顺序,为什么还要加position embedding?这对模型理解相对位置有什么帮助?讲一下Transformer以及位置编码。 「京东、字节跳动、拼多多、百度」
Transformer的位置编码作用及局限性?
什么是位置编码?在 Transformer 中,为什么它是必需的?请列举至少两种实现方式。
What is positional encoding, and why is it needed in Transformers?
问题2:Transformer 位置编码是什么?
73. 在 Transformer 中,位置编码的作用是什么?为什么要引入位置编码?
面试问题:请简述正弦余弦位置编码的原理,并推导说明其为何能表示相对位置关系。
1.位置编码在Transformer中的作用?
什么是位置编码?在 Transformer 中,为什么它是必需的?请列举至少两种实现方式。
简单介绍一下Transformer的位置编码?有什么意义和优缺点?
位置编码的作用是什么?
查看参考回答收起参考回答
RoPE 是旋转位置编码:在计算注意力分数前,按词元的位置旋转查询向量 Q 和键向量 K 的成对维度,让二者的点积自然包含相对位置差。这样,注意力在比较内容之外,还能区分两个词元的前后与间隔;它不是把一个位置向量直接加到词嵌入上。
标准做法使用预设的旋转频率,不需要为每个位置学习一行向量。公式可以计算更大的位置,但长文本效果还取决于训练长度、频率与缩放方案,不能据此保证任意长度都有效。
来源 · 20 份题集收起来源
推导 ROPE 的数学原理
【RoPE适配】奇数维hiddensize还能用RoPE吗?怎么适配? 「蚂蚁集团」
【旋转位置编码 vs 正余弦】旋转位置编码相比于传统正余弦位置编码的区别? 「阿里通义」
【FLUX位置编码】FLUX-Kontext和FLUX-Fill在模型结构上的区别,FLUX-Kontext的位置编码和FLUX-Fill的区别,在时间维度上什么区别,空间维度上有没有区别?FLUX中的RoPE是怎么工作的? 「腾讯混元、阿里巴巴」
【上下文不足】问我是否熟悉:RMS norm,layer Norm,激活函数(llava的),q-former,qk norm,rope,swigle 「百度」
旋转位置编码为什么比绝对位置编码更好
请你详细介绍ROPE,对比绝对位置编码它的优劣势分别是什么?
How does Rotary Position Embedding (RoPE) work, and why is it preferred over learned positional embeddings?
1.为什么选择qwen系列,qwen系列模型的发展 ,RoPE,外推,Attention(GQA和MLA)
2. 1D RoPE
问题3:位置编码介绍及ROPE(相对位置编码)的优势
57. ROPE(Rotary Position Embedding)位置编码有何特点?与原生位置编码相比有什么优势?
33.ROPE(Rotary Position Embedding)位置编码有何特点?
面试问题:RoPE 的高低频旋转圈数差异对应什么类型的依赖建模?ALiBi 位置编码与 RoPE 相比有什么优缺点?
9. 从几何+傅里叶角度,n维RoPE整体在做什么、代表什么?
面试问题:DCA、YaRN、RoPE 分别属于哪一代、各自解决什么问题?
12. RoPE 为什么能表达相对位置信息?
What is RoPE and why are rotary embeddings preferred over learned positional embeddings?
跟原始 Transformer 论文中的绝对位置编码相比,RoPE(旋转位置嵌入)有什么优点? RoPE 在长上下文外推时会面临什么挑战?
请你详细介绍ROPE,对比绝对位置编码它的优劣势分别是什么?
计算、缓存与推理优化
5 道题目查看参考回答收起参考回答
Self-Attention在同一层内,可以把所有位置的Q、K、V及相关性计算写成矩阵运算,训练时沿序列维并行。普通RNN的隐藏状态满足h_t=f(h_{t-1},x_t),当前位置必须等待上一步,序列内有递推依赖,因此难以获得同样的并行度。
Self-Attention还让相距很远的位置直接交互,缩短信息传递路径;代价是密集注意力的计算随序列长度平方增长,长文本的状态和访存也很重。流式、固定内存或端侧场景仍可能适合循环或状态空间结构,不能只凭训练并行性断言所有任务更优。
来源 · 2 篇面经 · 11 份题集收起来源
八股:Transformer底层原理,为啥能替代RNN
【缩放点积注意力】请讲解Transformer中的并行化机制,并详细说明多头注意力(Multi-Head Attention)的具体实现步骤,以及为什么在计算注意力得分时需要对点积结果进行缩放(即除以根号dk)? 「字节跳动、腾讯、腾讯混元」
How do RNNs and Transformers differ?
76. 为什么 Transformer 模型在处理序列数据方面比传统的 RNN 和 LSTM 模型有效率得多?
12.Transformer的并行化体现在哪里,Decoder可以做并行化嘛?
面试问题:相比 CNN 处理序列任务,Transformer 的核心优势和劣势分别是什么?为什么它能实现序列的并行计算?
3.Transformer的并行化体现在哪个地方?
请详细解释一下 Transformer 模型中的自注意力机制是如何工作的?它为什么比 RNN 更适合处理长序列?
Transformer的并行化体现在哪些地方?Decoder端可以做并行化吗?
Transformer的并行化提现在哪个地方?Decoder端可以做并行化吗?
7.Transformer代替seq2seq?
查看参考回答收起参考回答
MHA先将输入分别投影为Q、K、V,拆成多个头;每个头计算softmax(QKᵀ/√d_k)V,再拼接各头并通过输出投影。下面用PyTorch实现batch-first自注意力,包含布尔注意力掩码和key padding掩码;为突出机制,省略dropout、KV缓存及残差/归一化。
来源 · 2 篇面经 · 12 份题集收起来源
手撕多头注意力机制(不用PyTorch)
【Transformer、Attention、LoRA、MHA|L4】实现一个MultiHeadAttention,要求里面的Q、K、V的线性变换层引入LORA技术。 「腾讯」
Multi-Head Cross-Attention· 中等 🟡 中等 — Encoder-Decoder 架构基础
代码题:实现Casual mask的MHA,说下计算复杂度
【图片处理到Attention代码】手撕从图片处理到attention的具体代码 「阿里巴巴」
【Transformer注意力机制】Transformer注意力机制综合题: 1. 介绍Transformer组件:attention(除dk layernorm、rmsnorm、ffn、swiglu、MoE、lora和初始化)、GQA。 2. 介绍MHA的几种变体及改进方法。 3. 介绍FlashAttention。 4. 介绍长序列attention。 5. 手撕:实现多头自注意力(Multi-Head Attention)核心代码;实现多头注意力模块(MHA)并优化为MGA;实现多头注意力机制,包括softmax及数值溢出处理;写出自注意力伪代码(用abc预测第四个token,给定特征维度、头个数)。 6. 讨论多头注意力能否提高计算效率,并推导。 7. 在Agent多轮对话任务中,Attention的局限性体现在哪些方面? 8. 如果QK变成同一个矩阵会有影响吗?如何解决? 「京东、字节Seed、字节跳动、百度、美团、腾讯、腾讯混元、阿里巴巴、阿里通义」
Implement multi-head attention, then convert it to grouped-query attention.
10. 手撕:MHA
1. 题目一:手写完整的Multi-Head Attention,不能只写框架
手撕:多头注意力MHA代码
手写 Multi-Head Self-Attention
手撕 Multi-Head Attention
查看参考回答收起参考回答
GQA 把多个查询头分成若干组,一组查询头共享一组 K、V 头。查询头仍各自计算注意力,但需要生成和缓存的 K、V 更少,因此能减少生成阶段的缓存容量与读取带宽。它介于每个查询头都有独立 K、V 的 MHA,以及全部查询头共享一组 K、V 的 MQA 之间。
折中点是 K、V 的组数:共享越多,缓存越小,但表示能力和任务质量可能受影响。组数应结合模型训练后的任务效果、实际解码吞吐和显存来选,不能把缓存减少四倍直接说成整机推理快四倍。
来源 · 2 篇面经 · 19 份题集收起来源
除了MHA还知道哪些(GQA MQA MLA)讲原理
Explain Multi-Query Attention vs. Grouped Query Attention. Why are they important for inference?
【MHA/MQA/GQA对比】MHA、MQA、GQA分别是什么?各自的优缺点、适用场景、区别以及推理速度和显存占用上的差异? 「百度」
【MQA/GQA/MLA】实现GQA。实现MQA。MQA、GQA、MLA分别优化了什么?请手撕MQA和GQA,并说明Multi-Query Attention的好处。PLE,MMoE 讲一个了解的大模型 LoRA原理 MHA和GQA 流量很多的时候,KV Cache还可以做吗怎么做(没大听懂,不会) TRPO,PPO? 「京东、字节跳动、百度、腾讯、腾讯混元、阿里巴巴」
为什么大模型用GQA(Group Query Attention)
你知道MHA,MQA,GQA的区别吗?详细解释一下。
What is Grouped-Query Attention (GQA), and how does it differ from Multi-Head Attention (MHA)?
8. 8.多头注意力的变体有什么
面试问题:MQA和GQA如何压缩KV Cache?会带来什么影响?
58. 多头注意力机制MHA是Transformer模型中的核心组件,KVCache和GQA优化的核心思想是什么?
35.多头注意力机制MHA是Transformer模型中的核心组件,KVCache和GQA优化的核心思想?
面试问题:解释多头注意力(MHA)的核心思想,并介绍 MQA(多查询)和 GQA(分组查询)的区别及适用场景(KV Cache 显存优化)。
面试问题:多头注意力(MHA)、多查询注意力(MQA)和分组查询注意力(GQA)有什么区别?为什么 GQA 能降低键值头数?
面试问题:MHA、MQA、GQA 在 KV Cache 复杂度上有什么数学差异?
Compare MHA, MQA, and GQA. Why did Llama adopt GQA?
为什么注意力机制需要多个头?跟简单地减少注意力头的数量相比,多查询注意力和分组查询 注意力优化有什么不同?它们优化的是训练阶段还是推理阶段?
你知道MHA,MQA,GQA的区别吗?详细解释一下。
多头注意力(MHA)有哪些局限?MQA、GQA、Flash Attention 怎么解决?
GQA 和 MLA 的原理是什么?各自解决什么问题?
查看参考回答收起参考回答
KV Cache 缓存的是因果 Transformer 各层已经处理过的 token 的 Key 和 Value 张量。生成新 token 时,只计算这个新位置的 Q、K、V,再让新 Q 与历史及当前 K、V 做注意力,避免把整个前缀重新前向计算。历史 Q 不参与新位置的注意力,所以通常不用缓存。
它用显存换计算:减少重复的投影、前馈与注意力计算,但缓存会随上下文长度、并发序列数和层数增长。上下文很长时,读取历史 KV 的带宽和缓存容量又会成为瓶颈;KV Cache 不会让完整注意力的每一步都变成常数时间。
来源 · 3 篇面经 · 18 份题集收起来源
八股:解释KV Cache的内存瓶颈 推导多头注意力计算复杂度
KV cache 为什么容易成为容量瓶颈?
Walk me through what happens to the KV cache during a 1000-token generation on a 7B model.
KV Cache 为什么重要?PD 分离为什么热?
【KV Cache优化】KV Cache核心原理、多轮对话命中率优化、量化对生成质量的影响、污染处理方法。 「字节跳动、蚂蚁集团」
【Transformer推理优化】针对Transformer模型的自回归推理过程,forward中有哪些冗余计算可以省去?你会采用哪些优化手段? 「腾讯、蚂蚁集团」
为什么要优化KV Cache?
KV Cache是什么?为什么能极大地提升推理速度?
What is KV cache, and how does it speed up inference?
1. KV Cache是什么?为什么能加速大模型推理?
63. 介绍一下Transformer中KV Cache的原理,它能解决什么问题?有什么局限性?
42.介绍一下Transformer中KV Cache的原理
面试问题:批量推理时的计算瓶颈在哪里?请解释 KV Cache 的原理及其加速机制,并介绍 FlashAttention 的核心优化思路(IO 感知)。
面试问题:KV Cache、FlashAttention、长上下文优化背后的数学直觉是什么?
13. KV Cache 为什么能降低自回归推理计算?
What is the KV cache and why does it matter for inference? How does its memory scale?
KV Cache的优缺点
KV Cache 是什么?Prompt Caching 的原理是什么?
查看参考回答收起参考回答
FlashAttention通过分块与算子融合,在片上快速存储中完成注意力分数、softmax和乘V的计算,避免把完整N×N分数及概率矩阵反复写入、读出HBM。它主要减少显存占用和数据搬运,因此即使反向包含重算,也可能比朴素实现更快。
标准密集FlashAttention保留同一个注意力数学目标,不靠删掉token连接近似结果,计算量通常仍为O(N²d)。浮点累加次序、精度、dropout及内核实现不同会产生数值差异,所以“精确”指算法语义,不代表逐bit完全相同。
先用仓库和小工作台的类比,理解为什么减少中间结果搬运会带来收益:
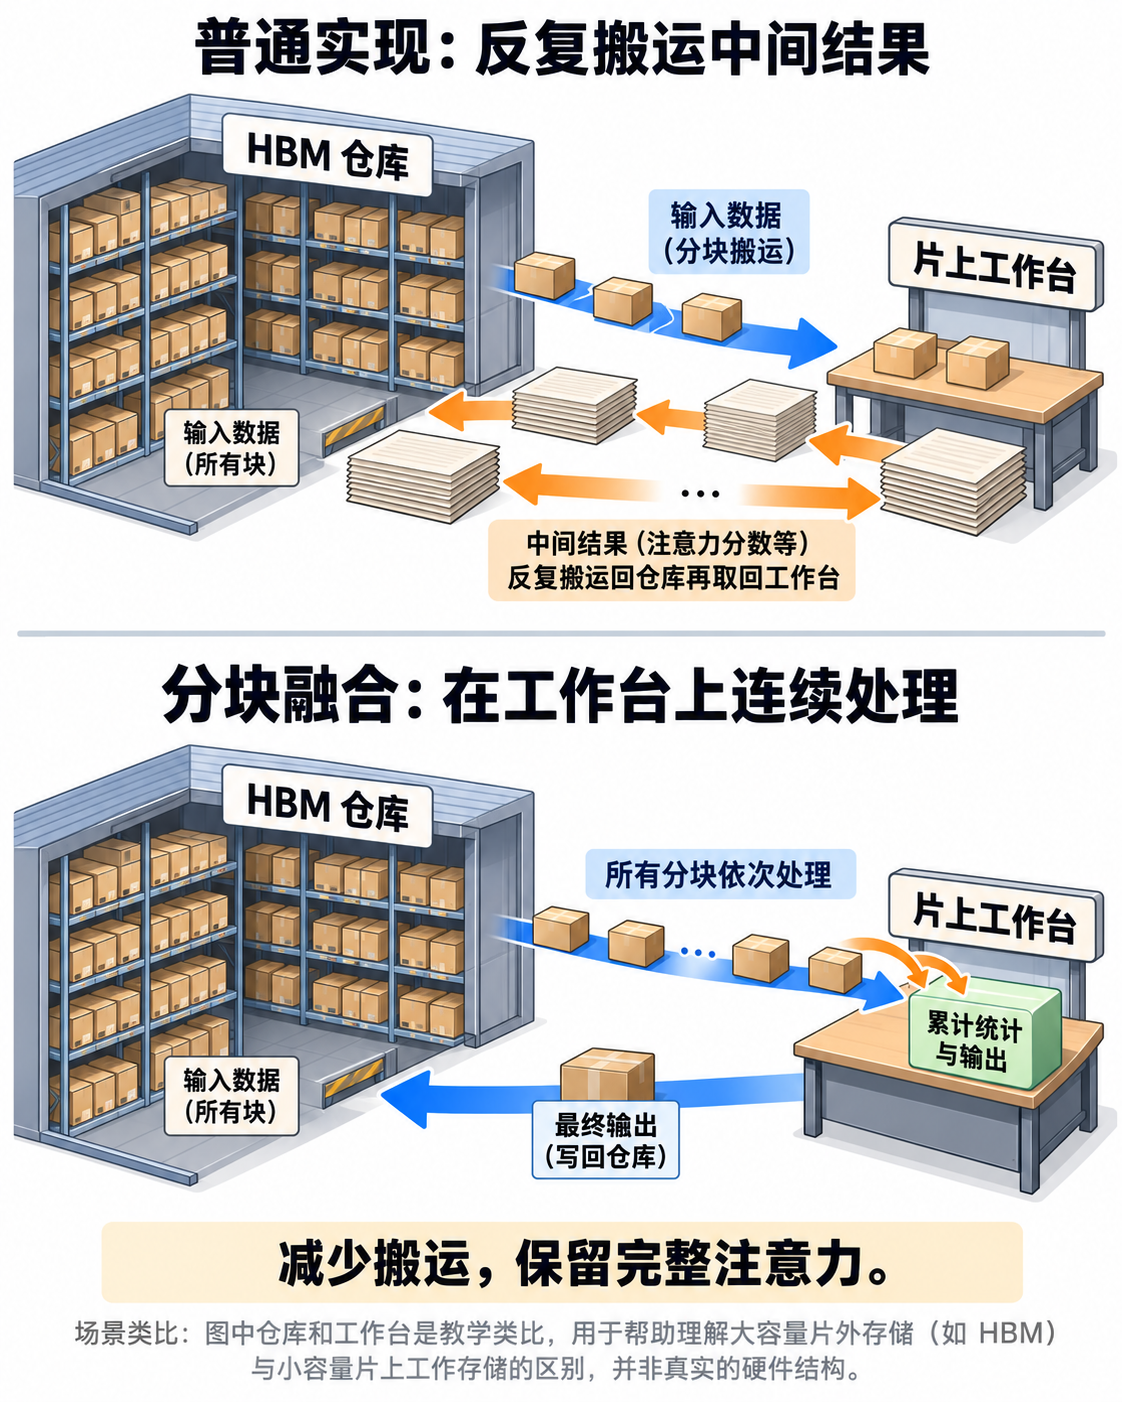
仓库类比 HBM,工作台类比容量较小的片上快速存储。所有分块仍参与完整注意力计算;下文继续解释分块 softmax 怎样保持全行归一。
来源 · 2 篇面经 · 19 份题集收起来源
Flash Attention 的优化原理
What improvements did FlashAttention-3 introduce for the H100, and how does it exploit H100-specific features?
Flash Attention 和标准 Attention 输出完全一样吗?
FlashAttention 为什么快?
【KV Cache】KV Cache原理;为什么query不用cache?KV Cache和Flash Attention基本原理。KV Cache怎么省显存?GQA/MQA的区别。了解Page Attention吗?为什么效果好?KV cache会造成显存过大的问题?如何解决?请讲下你理解的KV cache?上下文的特点是什么?为什么使用KV cache优化上下文? 「字节跳动、小红书、美团、蚂蚁集团、阿里巴巴」
【FlashAttention Kernel】FlashAttention的cuda kernel核心逻辑? 「阿里巴巴」
【长序列注意力优化】针对长序列中Attention计算复杂度高的问题,有哪些降低复杂度的方法?请列举并分类说明。其中一种方法是FlashAttention,请说明它与其他方法在技术上的异同。 「字节跳动、百度、腾讯、阿里巴巴」
介绍一下FlashAttention的原理
What is Flash Attention?
3. FlashAttention 跟普通 attention 的差异?实现里 QK^T、softmax、PV 这几步怎么落
面试问题:FlashAttention为什么能加速注意力计算?IO-aware具体指什么?
68. 简要说明FlashAttention的核心原理,它如何优化Transformer的注意力计算效率?
面试问题:批量推理时的计算瓶颈在哪里?请解释 KV Cache 的原理及其加速机制,并介绍 FlashAttention 的核心优化思路(IO 感知)。
面试问题:快速注意力(FlashAttention)为什么更快?它是否改变了注意力结果?
面试问题:Flash Attention 为什么能加速大语言模型中的 Attention?它主要优化的是计算量还是显存访问?
面试问题:KV Cache、FlashAttention、长上下文优化背后的数学直觉是什么?
14. FlashAttention 的 Online Softmax 如何保证精确?
Flash Attention 并不能减少计算量,为什么能提升推理速度? Flash Attention 是如何实现增量计算 softmax 的?
FlashAttention 为什么更快?Online Softmax、Tiling、重计算和不同版本分别解决什么瓶颈?
残差连接与 FFN
2 道题目查看参考回答收起参考回答
残差连接把一个模块写成 y=x+F(x):输入 x 沿捷径保留下来,网络学习的是在它上面增加什么变化。相比让一串层从头学出完整映射,这种方式让接近恒等的映射更容易表示,并给信息和梯度提供直接通路,缓解深层网络难以优化、加深后训练误差反而上升的问题。
它主要改善深层优化,不等于消除过拟合,也不保证任意深度都不会梯度消失或爆炸。实际训练仍与归一化位置、初始化、学习率和残差分支的尺度有关。
来源 · 1 篇面经 · 10 份题集收起来源
【过拟合与欠拟合】过拟合是什么?如何判断和缓解过拟合?欠拟合和loss震荡的原因和解决方法是什么?另外,请说明BN和LN的区别及适用场景,以及梯度爆炸问题、残差连接和模型参数初始化的相关内容。 「拼多多、腾讯、阿里巴巴」
What are skip connections (residual connections) in Transformers?
面试问题:ResNet 为什么是最重要的 CNN 经典模型之一?
75. 在 Transformer 模型中,层归一化(Layer Normalization)和残差连接(Residual Connection)的目的是什么?
9.介绍一下Transformer的残差结构及意义
为什么ResNet可以很深?
面试问题:Transformer 中为什么要使用残差连接 + 层归一化?Pre-LN(前置)相比 Post-LN(后置)有什么区别?为什么大模型普遍用 Pre-LN?
面试问题:SD Backbone中为什么设计GroupNorm+SiLU+残差连接的组合?
面试问题:在大语言模型中,注意力(Attention),前馈层(FFN),残差连接和归一化各自解决什么问题?
简单讲一下Transformer中的残差结构以及意义。
查看参考回答收起参考回答
FFN 对每个词元的隐藏向量独立做非线性特征变换。原始 Transformer 中,它由“线性升维→非线性激活→线性投影回原维”组成,同一层中所有位置共享这套参数。它为模型补充特征加工能力,输出回到模型维度后,便于与残差分支相加。
注意力主要负责在不同位置之间交换信息,FFN 主要在单个位置的特征维度上加工。这里的“独立”指该层不直接读取其他位置,不代表输入没有上下文:前面的注意力已经把上下文信息融入了隐藏向量。
来源 · 1 篇面经 · 10 份题集收起来源
【FFN维度】FFN为什么通常是4×dim? 「京东」
What are Feed-Forward Networks in LLMs?
3.FFN是干嘛的?
33. Transformer的前馈网络(FFN)在模型中承担什么角色?
20.Transformer中的FeedForward模块有什么作用?
面试问题:Transformer 的 FFN(前馈网络)起什么作用?为什么大模型常用 SwiGLU 替代传统的 ReLU/GELU?
面试问题:在大语言模型中,注意力(Attention),前馈层(FFN),残差连接和归一化各自解决什么问题?
2. 大语言模型常用的FFN结构是什么?
1.介绍一下 FFN 块 计算公式?
3.8 FFN的作用?